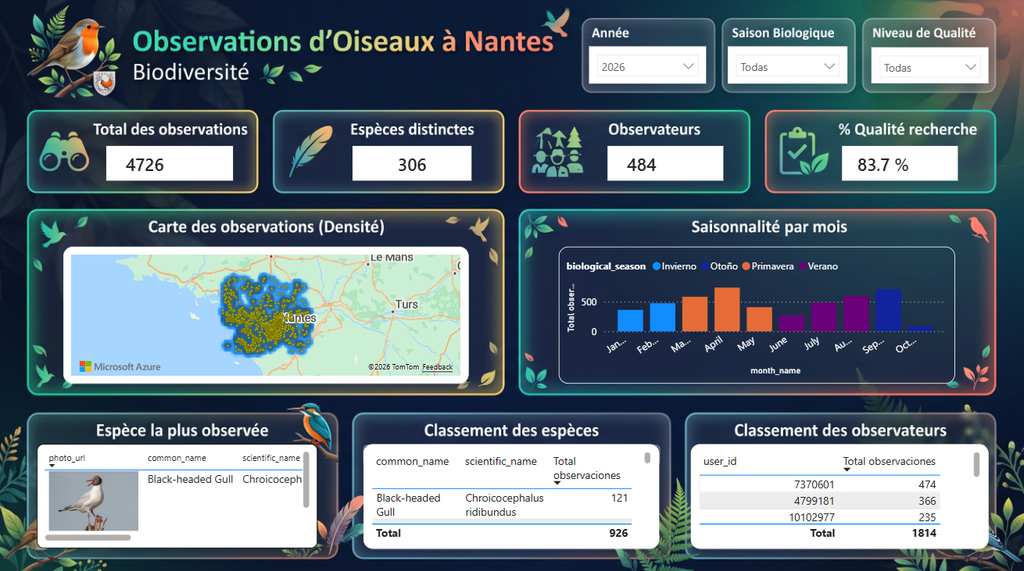
Un pipeline ELT de extremo a extremo en AWS que cada mañana convierte las observaciones naturalistas de iNaturalist en un dashboard de Power BI.
AWS Lambda S3 Athena dbt Apache Airflow Terraform Power BI GitHub Actions
Proyecto personal · Diseño, desarrollo y despliegue · Código en GitHub
Contexto y problema
Miles de naturalistas comparten sus observaciones de aves en iNaturalist. Pero esos datos en bruto (archivos JSON voluminosos y anidados) no permiten responder fácilmente a preguntas como: ¿qué especies se observan alrededor de Nantes? ¿En qué época del año? ¿Dónde?
El objetivo era construir un pipeline fiable, automatizado y de bajo coste que recoja esos datos cada día, garantice su calidad y los ponga a disposición de una herramienta de análisis, aplicando las prácticas del modern data stack.
La solución
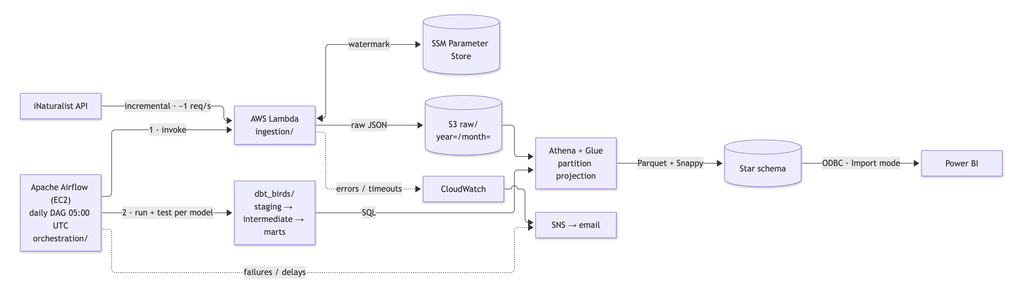
El pipeline sigue una arquitectura ELT: los datos se cargan primero en bruto y después se transforman dentro del data lake.
- Ingesta: una función AWS Lambda consulta la API REST de iNaturalist de forma incremental (solo las observaciones nuevas desde la última ejecución) y guarda el JSON en bruto en S3.
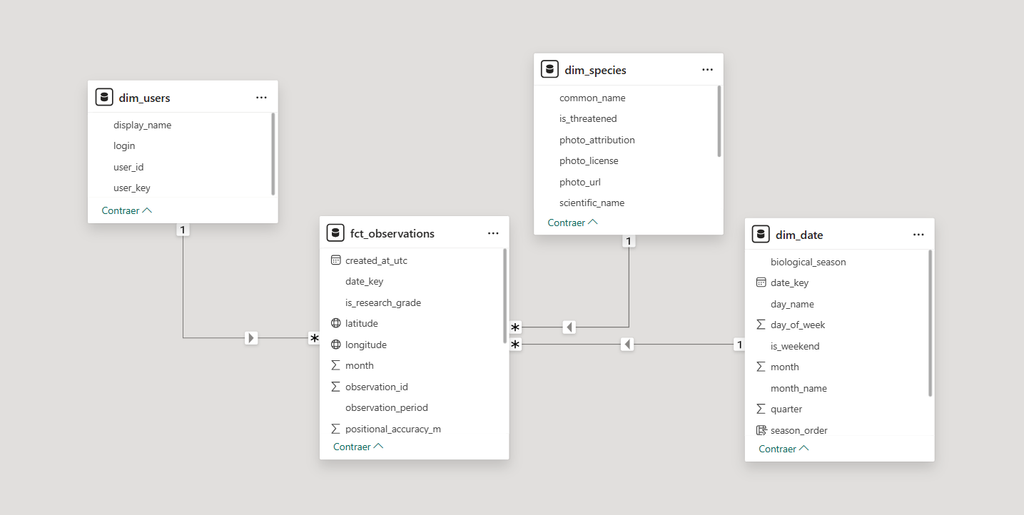
- Transformación: dbt, ejecutado sobre Amazon Athena, limpia y estructura los datos en una arquitectura medallón (raw → staging → marts) hasta un modelo en estrella en Parquet.
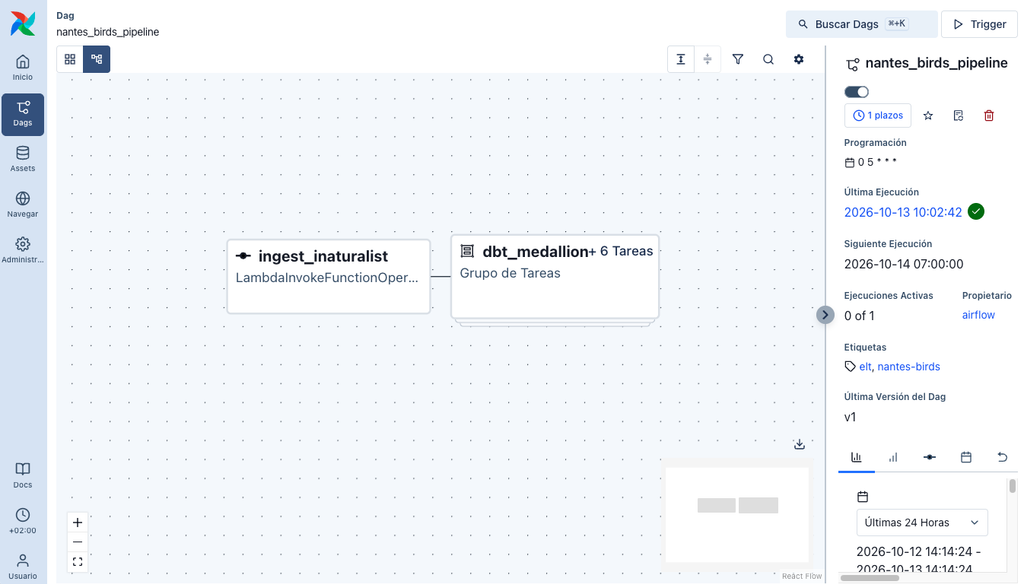
- Orquestación: Apache Airflow 3 encadena cada mañana la ingesta y después cada modelo dbt con sus tests, con reintentos automáticos y alertas por email.
- Visualización: Power BI se conecta a las tablas finales: mapa de densidad, estacionalidad, rankings y fotos de las especies.
Stack y mi papel
| Capa | Herramientas |
|---|---|
| Ingesta | AWS Lambda (Python), SSM Parameter Store |
| Almacenamiento | Amazon S3 (data lake), AWS Glue Data Catalog |
| Transformación | dbt Core, Amazon Athena, Parquet |
| Orquestación | Apache Airflow 3, Astronomer Cosmos, EC2 |
| Infraestructura | Terraform, IAM (mínimo privilegio), Session Manager |
| Calidad y CI | 77 tests de dbt, pytest, GitHub Actions |
| Visualización | Power BI |
Mi papel: proyecto realizado de principio a fin: especificación, modelado de datos, desarrollo, infraestructura como código, despliegue en producción y documentación.
Detalles técnicos
Ingesta incremental e idempotente. Un watermark guardado en SSM recuerda la última ejecución correcta y solo avanza después de una escritura exitosa en S3. Si algo falla, la siguiente ejecución retoma desde el mismo punto, sin perder datos ni duplicarlos.
La calidad de los datos como barrera. Cada modelo dbt va seguido de sus tests (unicidad, valores nulos, área geográfica, integridad referencial). Un test fallido bloquea automáticamente todos los modelos que dependen de él: un dato inválido nunca llega al dashboard.
Orquestación detallada. Gracias a Cosmos, cada modelo dbt se convierte en una pareja de tareas de Airflow (ejecución + test): 13 tareas visibles y relanzables una a una.
Seguridad y costes. Instancia EC2 sin ningún puerto abierto (acceso mediante Session Manager), roles IAM de mínimo privilegio, Parquet comprimido y particionado. Coste total: unos 20 USD al mes.
Retos y aprendizajes
El despliegue en condiciones reales sacó a la luz problemas que ningún entorno de pruebas habría mostrado. Corregí y documenté doce, entre ellos:
- Una tabla incremental peligrosa: la estrategia
insert_overwritehabría borrado cada día los datos del mes en curso. Con unas 18.000 filas, reconstruir la tabla completa a diario resultó más simple, siempre correcto e igual de barato. - Fechas ISO 8601 con zona horaria que Athena rechazaba, corregidas con
from_iso8601_timestamp. - Una carga inicial demasiado larga para Lambda (límite de 3 minutos): el histórico se cargó una única vez fuera de Lambda y, desde entonces, el pipeline solo procesa lo nuevo.
- Decisiones de calidad de datos: 77 observaciones sin fecha se conservan en staging con un aviso, pero se excluyen del modelo analítico.
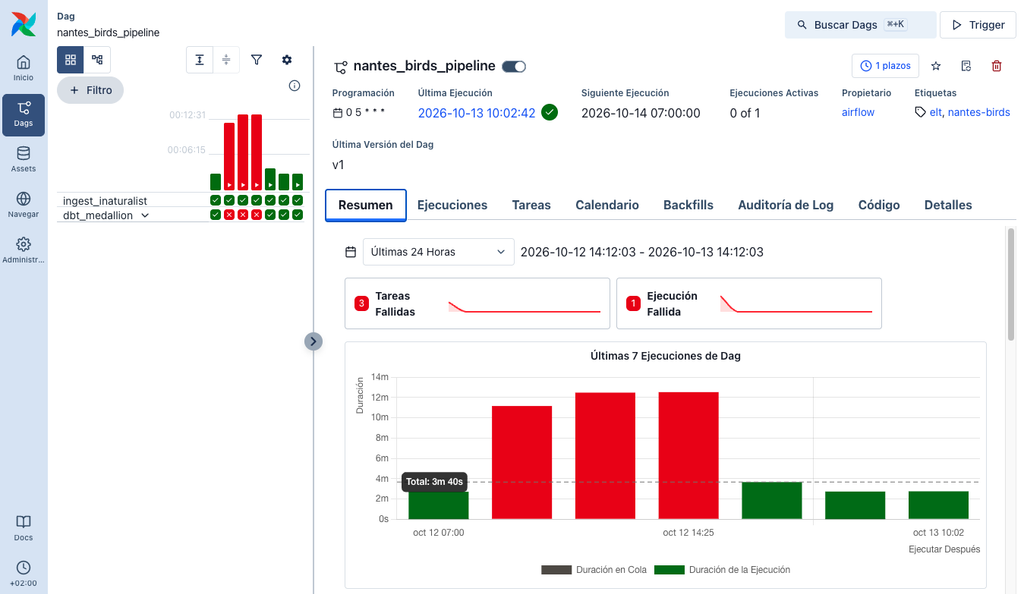
Lo que me llevo: un pipeline no está terminado hasta que funciona solo en producción, y saber cuándo no usar una técnica avanzada también forma parte del oficio.
Resultados
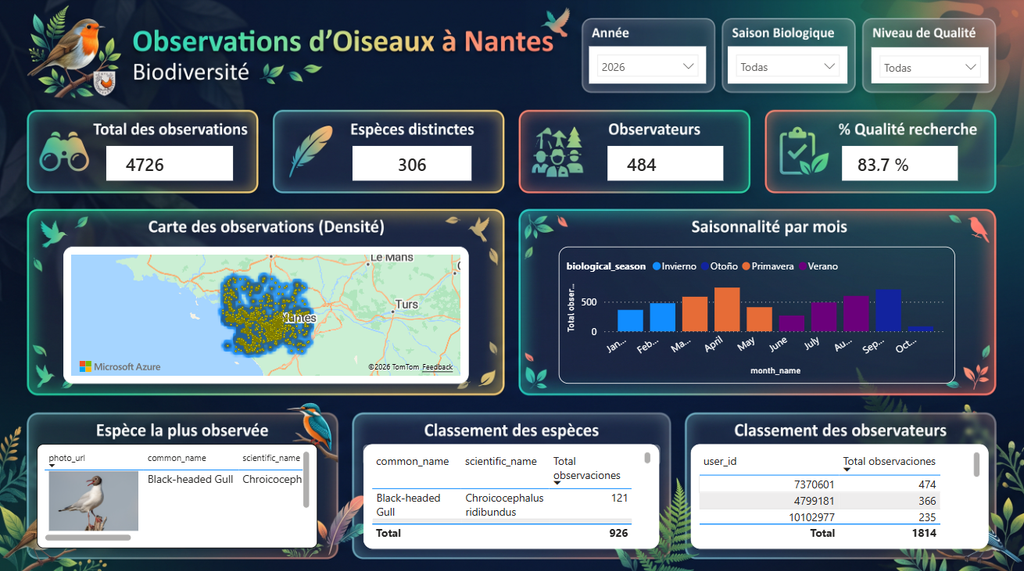
- ✅ En producción desde octubre de 2026, con ejecución automática cada mañana
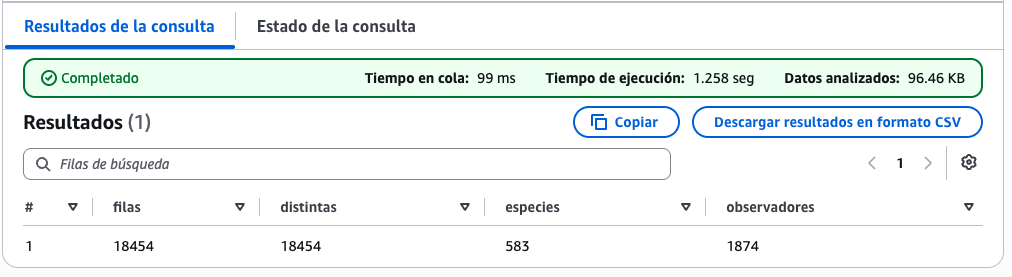
- 18.454 observaciones, 583 taxones, 1.874 observadores (de 1970 a hoy)
- 77 tests de calidad de datos en cada ejecución
- ~20 USD al mes de infraestructura
- Documentación completa: guía de despliegue paso a paso, operación y resultados de validación
Próximos pasos y enlaces
Próximos pasos: historial SCD Tipo 2 con snapshots de dbt, tests de dbt contra Athena en la CI (OIDC), despliegue continuo y análisis horario a partir de la hora real de observación.
🔗 Código y documentación en GitHub · Publicación en LinkedIn
💼 Estoy abierto a oportunidades en Data Engineering / Analytics Engineering.
Contáctame