Un pipeline ELT de bout en bout sur AWS qui transforme chaque matin les observations naturalistes d’iNaturalist en tableau de bord Power BI.
AWS Lambda S3 Athena dbt Apache Airflow Terraform Power BI GitHub Actions
Projet personnel · Conception, développement et déploiement · Code sur GitHub
Contexte et problème
Des milliers de naturalistes partagent leurs observations d’oiseaux sur iNaturalist, mais ces données brutes (des fichiers JSON volumineux et imbriqués) ne permettent pas de répondre simplement à des questions comme : quelles espèces observe-t-on autour de Nantes ? À quelle saison ? Où ?
L’objectif était de construire un pipeline fiable, automatisé et peu coûteux qui collecte ces données chaque jour, garantit leur qualité et les met à disposition dans un outil d’analyse, en appliquant les pratiques du modern data stack.
La solution
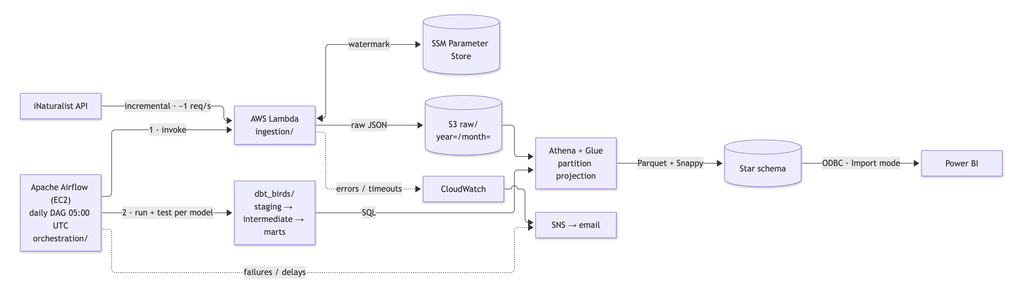
Le pipeline suit une architecture ELT : les données sont d’abord chargées brutes, puis transformées dans le data lake.
- Ingestion : une fonction AWS Lambda interroge l’API REST d’iNaturalist de façon incrémentale (seules les nouvelles observations depuis la dernière exécution) et dépose le JSON brut dans S3.
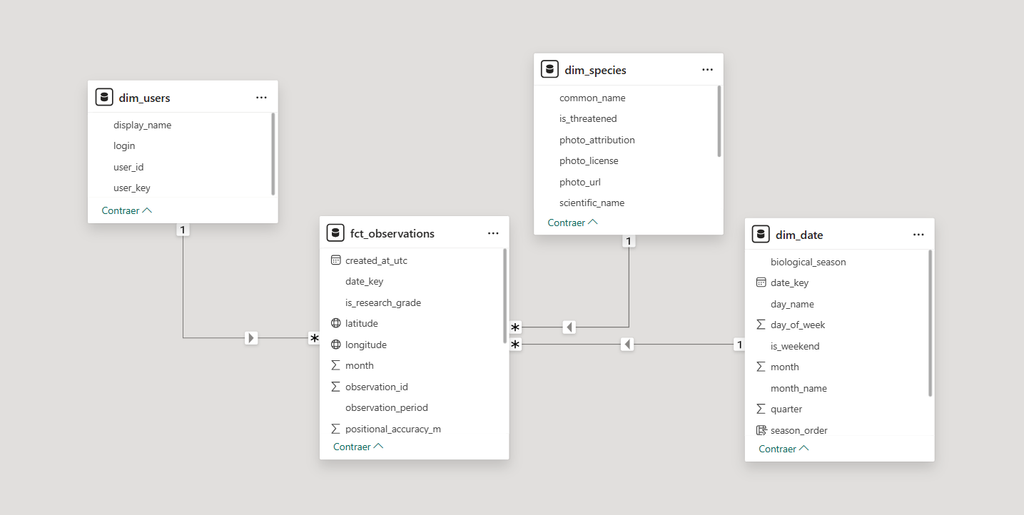
- Transformation : dbt, exécuté sur Amazon Athena, nettoie et structure les données selon une architecture médaillon (raw → staging → marts) jusqu’à un schéma en étoile en Parquet.
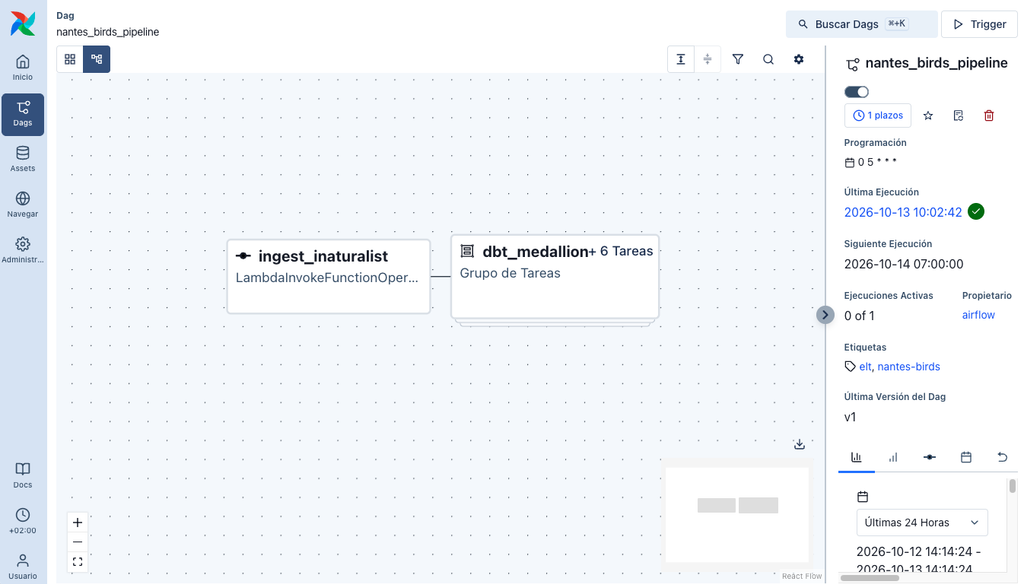
- Orchestration : Apache Airflow 3 enchaîne chaque matin l’ingestion puis chaque modèle dbt et ses tests, avec reprises automatiques et alertes e-mail.
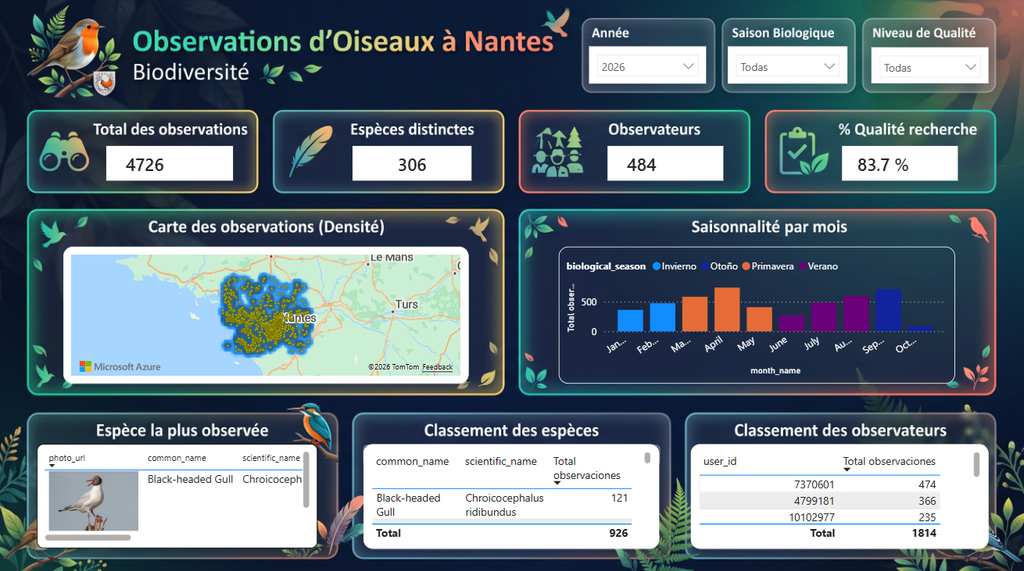
- Restitution : Power BI se connecte aux tables finales : carte de densité, saisonnalité, classements et photos des espèces.
Stack et mon rôle
| Couche | Outils |
|---|---|
| Ingestion | AWS Lambda (Python), SSM Parameter Store |
| Stockage | Amazon S3 (data lake), AWS Glue Data Catalog |
| Transformation | dbt Core, Amazon Athena, Parquet |
| Orchestration | Apache Airflow 3, Astronomer Cosmos, EC2 |
| Infrastructure | Terraform, IAM (moindre privilège), Session Manager |
| Qualité et CI | 77 tests dbt, pytest, GitHub Actions |
| Visualisation | Power BI |
Mon rôle : projet réalisé de A à Z : spécification, modélisation des données, développement, infrastructure as code, déploiement en production et documentation.
Détails techniques
Ingestion incrémentale et idempotente. Un watermark stocké dans SSM mémorise la dernière exécution réussie ; il n’avance qu’après une écriture réussie dans S3. En cas d’échec, l’exécution suivante reprend au même point, sans perte ni doublon.
Qualité des données comme garde-fou. Chaque modèle dbt est suivi de ses tests (unicité, valeurs nulles, zone géographique, intégrité référentielle). Un test en échec bloque automatiquement tous les modèles qui en dépendent : une donnée invalide n’atteint jamais le tableau de bord.
Orchestration fine. Grâce à Cosmos, chaque modèle dbt devient une paire de tâches Airflow (exécution + test) : 13 tâches visibles, relançables individuellement.
Sécurité et coûts. Instance EC2 sans aucun port ouvert (accès via Session Manager), rôles IAM au moindre privilège, Parquet compressé et partitionné. Coût total : environ 20 $ par mois.
Défis et apprentissages
Le déploiement en conditions réelles a révélé des problèmes qu’aucun environnement de test n’aurait montrés. Douze ont été corrigés et documentés, dont :
- Une table incrémentale dangereuse : la stratégie
insert_overwriteaurait effacé chaque jour les données du mois en cours. Avec ~18 000 lignes, une reconstruction complète quotidienne s’est révélée plus simple, toujours correcte et aussi peu coûteuse. - Des formats de date ISO 8601 avec fuseau horaire refusés par Athena, corrigés avec
from_iso8601_timestamp. - Un chargement initial trop long pour Lambda (limite de 3 minutes) : l’historique a été chargé une seule fois hors de Lambda, puis le pipeline ne traite que les nouveautés.
- Des décisions de qualité de données : 77 observations sans date sont conservées en staging (avertissement) mais exclues du modèle analytique.
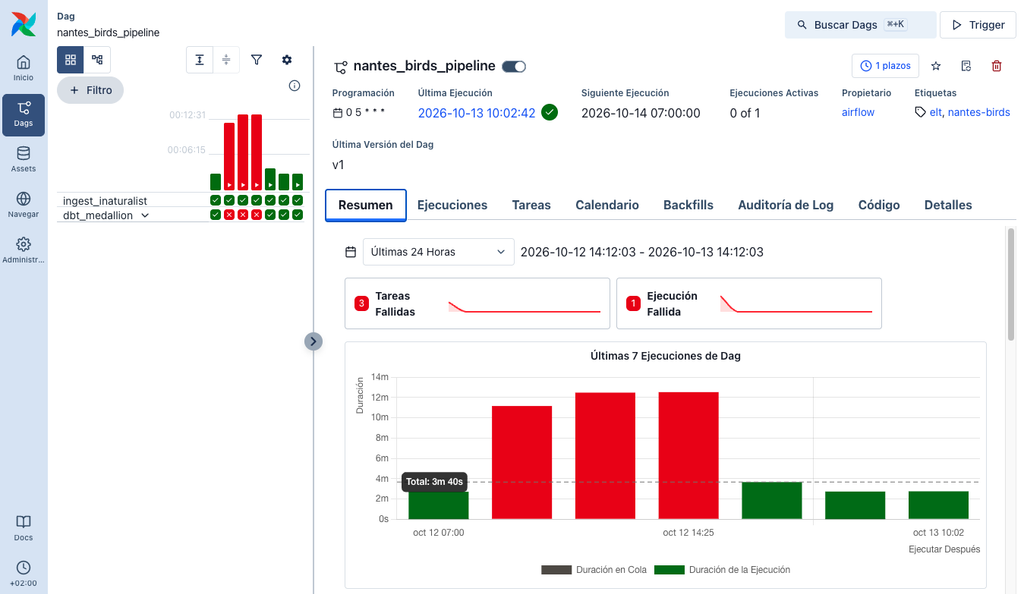
Ce que j’en retiens : un pipeline n’est terminé que lorsqu’il tourne seul en production, et savoir quand ne pas utiliser une technique avancée fait partie du métier.
Résultats
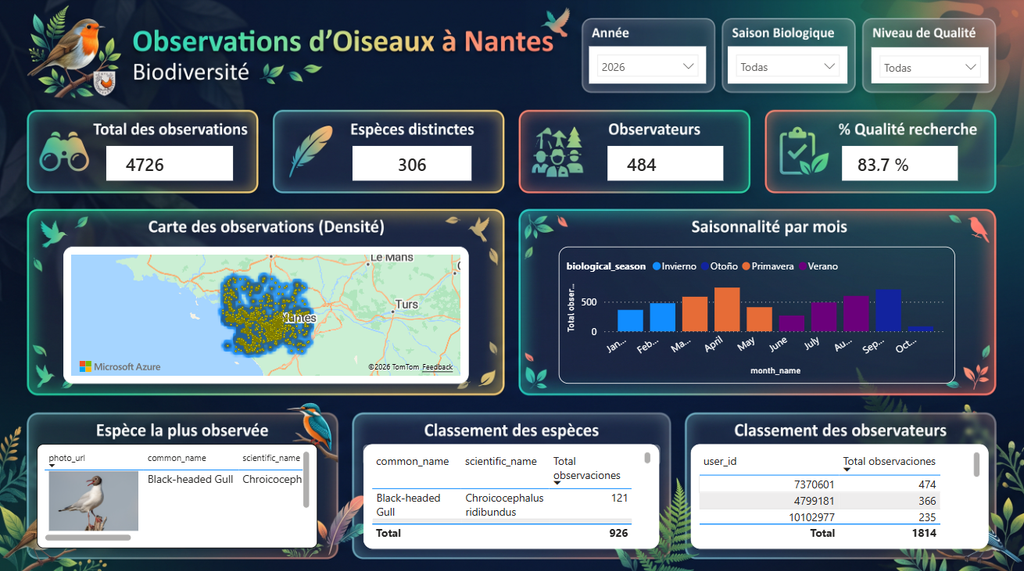
- ✅ En production depuis octobre 2026, exécution automatique chaque matin
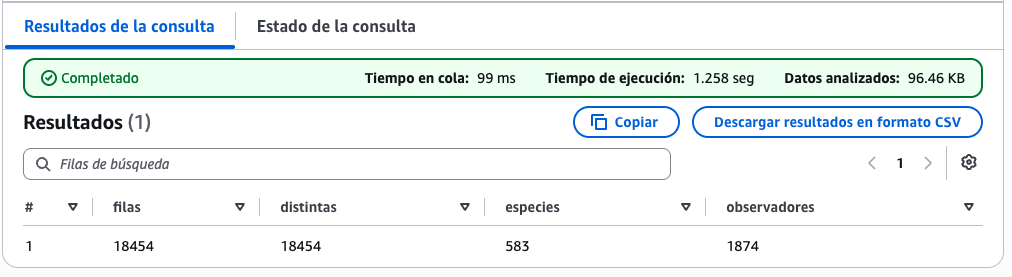
- 18 454 observations, 583 taxons, 1 874 observateurs (de 1970 à aujourd’hui)
- 77 tests de qualité des données à chaque exécution
- ~20 $ / mois d’infrastructure
- Documentation complète : guide de déploiement pas à pas, exploitation, résultats de validation
Prochaines étapes et liens
Prochaines étapes : historisation SCD Type 2 avec les snapshots dbt, tests dbt sur Athena dans la CI (OIDC), déploiement continu, analyse horaire à partir de l’heure réelle d’observation.
🔗 Code et documentation sur GitHub · Publication LinkedIn
💼 Je suis ouvert à des opportunités en Data Engineering / Analytics Engineering.
Contactez-moi